
En del af:
Hvad er teknisk SEO? Tjekliste til din hjemmeside
Teknisk SEO sikrer, at Google kan finde, læse og indeksere dine sider. Her er forklaringen på crawl, indeksering, rendering, hastighed og struktur, og en tjekliste med gratis værktøjer.

Teknisk SEO er arbejdet med at sikre, at Google og andre søgemaskiner kan finde, læse, forstå og gemme dine sider hurtigt og uden fejl. Det er fundamentet under dit indhold: Er det i stykker, hjælper selv den bedste tekst ikke.
Teknisk SEO handler ikke om søgeord eller om at skrive gode tekster. Det handler om crawl, indeksering, rendering, hastighed og struktur. Her får du en forklaring af hvert område, de fejl vi oftest ser, og en tjekliste med gratis værktøjer, du kan gå i gang med i dag.
Det korte svar
- Crawl: Google skal kunne finde dine sider via links og sitemap.
- Indeksering: Siderne må ikke være blokeret, og der skal være én klar version af hver side.
- Rendering: Vigtigt indhold og links skal være i HTML’en, ikke gemt bag JavaScript eller klik.
- Hastighed: Core Web Vitals måler indlæsning (LCP ≤ 2,5 s), respons (INP ≤ 200 ms) og visuel stabilitet (CLS ≤ 0,1).
- Struktur: Logiske URL’er, få klik til vigtige sider, HTTPS og en mobilvenlig side.
Hvad er forskellen på teknisk SEO, on-page og off-page?
SEO bliver typisk delt op i tre områder. De hænger sammen, men det er nyttigt at holde dem adskilt, når du skal finde ud af, hvor problemet ligger.
| Område | Spørgsmålet det besvarer | Eksempler |
|---|---|---|
| Teknisk SEO | Kan Google finde, læse og gemme siden? | robots.txt, statuskoder, sitemap, canonical, hastighed, JavaScript, HTTPS |
| On-page SEO | Er indholdet det bedste svar på søgningen? | Tekst, overskrifter, sidetitler, metabeskrivelser, billeder, interne links i teksten |
| Off-page SEO | Stoler resten af nettet på dig? | Links fra andre sites, omtale, anmeldelser, Google Business Profile |
Hvordan finder og læser Google din hjemmeside?
Al teknisk SEO giver mening, når du kender de fire trin, en side går igennem, før den kan blive vist i Google:
- Crawl: Googlebot finder URL’en via et link eller dit sitemap og henter den.
- Rendering: Google kører sidens JavaScript og ser siden, som en browser ville.
- Indeksering: Google vurderer, om siden skal gemmes, og hvilken version der er den rigtige.
- Visning: Når nogen søger, vælger Google blandt de indekserede sider. Det gælder også AI Overviews og AI Mode, som bygger på det samme indeks.
Fejler et trin, når siden aldrig videre. Det er derfor, teknisk SEO kommer før alt andet.
Crawl: Kan Google finde dine sider?
Google finder nye sider på to måder: ved at følge links og ved at læse dit XML-sitemap. En side, som ingen andre sider linker til (en såkaldt orphan page), bliver sjældent prioriteret, selv om den står i sitemappet.
- robots.txt fortæller crawlere, hvad de ikke må hente. Bloker kun det, der aldrig skal findes, fx interne søgeresultater og kurv. Bloker aldrig CSS- og JavaScript-filer, som siden skal bruge for at blive vist rigtigt.
- XML-sitemap skal kun indeholde sider, der svarer med statuskode 200, og som du gerne vil have indekseret. Indsend det i Google Search Console.
- Parametre og filtre kan skabe tusindvis af næsten ens URL’er på en webshop, fx ?farve=blå&str=42&sort=pris. Brug canonical og interne links, så Google bruger tiden på de rigtige sider.
- Crawl budget er først et reelt problem på store sites med mange tusinde URL’er. På en almindelig firmahjemmeside er det næsten aldrig flaskehalsen.
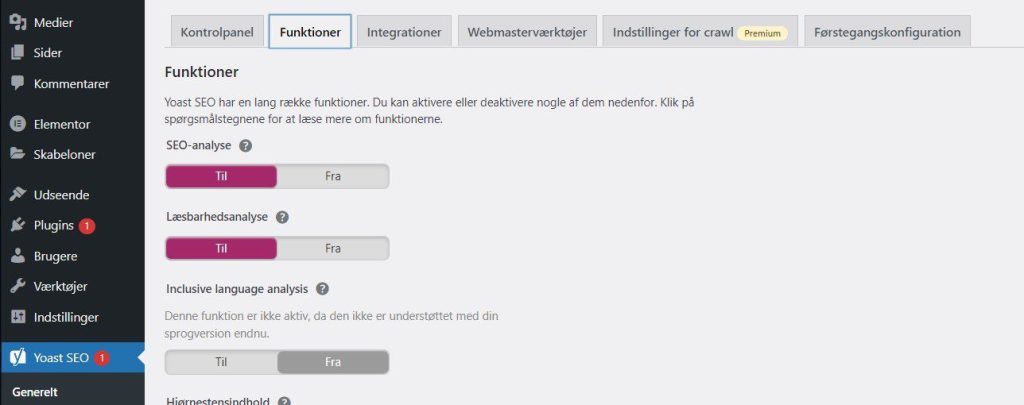
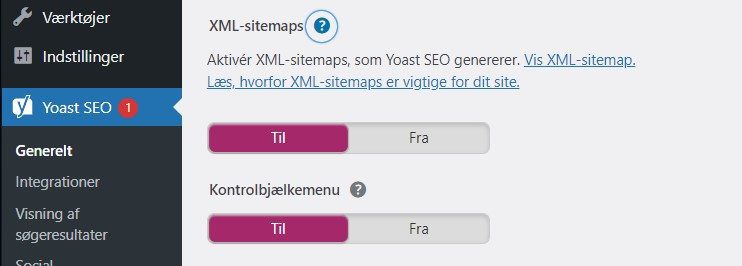
I WordPress laver dit SEO-plugin sitemappet for dig. Er du ny, anbefaler vi Yoast SEO, fordi det er det enkleste at komme i gang med. I Yoast SEO er XML-sitemaps slået til fra start. Du finder indstillingen i Yoast-menuen i venstre side under Yoast SEO → Indstillinger → Webstedsfunktioner, og sitemappet ligger typisk på /sitemap_index.xml. Bruger du Rank Math, finder du det under Rank Math SEO → Sitemap-indstillinger.
Statuskoder du skal kende
| Kode | Betyder | Hvornår er det et problem? |
|---|---|---|
| 200 | Siden virker | Når en tom eller “ikke fundet”-side svarer 200. Det kaldes en soft 404. |
| 301 | Flyttet permanent | Når flere redirects kædes sammen (A til B til C), eller interne links stadig peger på den gamle adresse |
| 302 / 307 | Flyttet midlertidigt | Når flytningen i virkeligheden er permanent |
| 404 / 410 | Findes ikke / fjernet | Når interne links, sitemap eller vigtige eksterne links peger derhen |
| 5xx | Serverfejl | Altid. Gentager det sig, sænker Google crawl-tempoet |
Indeksering: Må og vil Google gemme siden?
At Google kan hente en side, betyder ikke, at den kommer i indekset. Tre ting styrer det:
- noindex i et meta-tag eller en HTTP-header fortæller Google, at siden ikke skal med. Brug det på takkesider, login, tynde tag-arkiver og lignende.
- canonical fortæller Google, hvilken URL der er den foretrukne, når det samme indhold findes flere steder.
- Kvalitet: Google indekserer ikke alt. Tynde eller næsten ens sider ender ofte som “crawlet, men ikke indekseret”.
Klassisk fejl: robots.txt og noindex sammen
robots.txt stopper crawl, ikke indeksering. Blokerer du en side i robots.txt, kan Google ikke se dens noindex-tag, og siden kan stadig dukke op i søgeresultaterne uden beskrivelse. Vil du have en side ud af Google, så lad Google crawle den og brug noindex.
Du ser status for alle dine sider i Google Search Console under rapporten Sider (sideindeksering). Her står det, hvilke sider der er indekseret, og hvorfor resten ikke er. Med URL-inspektion kan du tjekke en enkelt side og se, hvordan Google har renderet den.
Rendering: Kan Google se dit indhold?
Google kan køre JavaScript, men det sker i et ekstra trin, og ikke alt bliver altid renderet perfekt. Andre søgemaskiner og mange AI-crawlere kører slet ikke JavaScript. Derfor er tommelfingerreglen enkel: Det vigtige skal stå i den HTML, serveren sender.
- Tekst, priser og produktinformation skal være i HTML’en, ikke hentes ind efter et klik.
- Links skal være rigtige <a href>-links. Knapper med JavaScript-klik kan Google ikke følge.
- Bygger du med React, Vue eller lignende, så brug server-side rendering eller statisk generering til de sider, der skal findes.
Et hurtigt tjek: Højreklik på siden, vælg “Vis sidekilde”, og søg efter en sætning fra dit indhold. Kan du ikke finde den, er den kun tilgængelig efter rendering.
Hastighed: Hvad måler Core Web Vitals?
Core Web Vitals er Googles tre målinger af brugeroplevelsen. De måler indlæsning, respons og visuel stabilitet, altså hvor hurtigt siden vises, hvor hurtigt den reagerer, og om indholdet hopper rundt. De måler ikke tilgængelighed for handicappede; det er et separat område.
| Måling | Hvad måler den? | God | Dårlig |
|---|---|---|---|
| LCP (Largest Contentful Paint) | Indlæsning: hvornår det største element er vist | ≤ 2,5 sek. | > 4 sek. |
| INP (Interaction to Next Paint) | Respons: hvor hurtigt siden reagerer på klik og tastetryk | ≤ 200 ms | > 500 ms |
| CLS (Cumulative Layout Shift) | Visuel stabilitet: hvor meget indholdet flytter sig | ≤ 0,1 | > 0,25 |
Du måler dine egne tal i PageSpeed Insights, hvor feltdata fra rigtige brugere står øverst. Vi har skrevet en guide til Google PageSpeed Insights, der forklarer, hvordan du læser rapporten. De typiske løsninger er de samme på de fleste sites: komprimerede billeder i AVIF eller WebP, caching, færre scripts fra plugins og tracking, og fast plads til billeder og bannere.
Struktur: URL’er, interne links og mobil
En god struktur hjælper både Google og dine besøgende med at forstå, hvad der er vigtigst på sitet.
- Klikdybde: Dine vigtigste sider bør kunne nås med få klik fra forsiden.
- URL’er: Korte, læsbare og stabile, fx /services/webshop/ frem for /?page_id=482. Skifter du URL, så lav en 301-redirect.
- Interne links: Link fra relevante sider med beskrivende linktekst. Det er den stærkeste måde at fortælle Google, hvad der er vigtigt.
- Breadcrumbs: Viser hierarkiet og giver ekstra interne links.
- Overskrifter: Én H1 pr. side og H2/H3 i logisk rækkefølge. Det gør siden lettere at læse for både mennesker og maskiner.
- Mobil: Google indekserer mobilversionen af din side. Indhold, der mangler på mobil, findes ikke for Google.
- HTTPS: Alle sider skal køre på https med én 301 fra http og fra www/uden www, ikke en kæde.
Strukturerede data: Hvad giver stadig mening?
Strukturerede data (schema markup i JSON-LD) beskriver dit indhold for maskiner: hvem I er, hvad produktet koster, hvem der har skrevet artiklen. Hvor koden står på siden, er ligegyldigt, så længe den matcher det synlige indhold.
Brug de typer, der beskriver din forretning: Organization, LocalBusiness, Product, Article og BreadcrumbList. Vær opmærksom på, at FAQ-resultater ikke længere vises i Google, og HowTo-resultater forsvandt i 2023. Google kræver heller ingen særlig markup for at vise dit indhold i AI Overviews. Læs mere i vores guide til strukturerede data og AI-synlighed.
AI-crawlere og robots.txt: Hvem skal have adgang?
Ud over Googlebot besøges dit site af crawlere fra AI-tjenester. Nogle bruges til søgning, andre til at træne sprogmodeller, og du kan styre dem hver for sig i robots.txt.
| Crawler | Bruges til | Hvis du blokerer den |
|---|---|---|
| Googlebot | Google Search, også AI Overviews og AI Mode | Du forsvinder fra Google |
| Google-Extended | Træning af Gemini og grounding i Googles andre AI-produkter | Ingen effekt på Google Search eller placeringer |
| OAI-SearchBot | Søgning i ChatGPT | Du vises ikke i ChatGPT’s søgesvar |
| GPTBot | Træning af OpenAI’s modeller | Dit indhold bruges ikke til træning |
| Claude-SearchBot | Søgning i Claude | Lavere synlighed i Claudes søgesvar |
| ClaudeBot | Træning af Anthropics modeller | Dit indhold bruges ikke til træning |
Der findes ingen særlig AI-fil, du skal lave for at blive vist i Googles AI-svar. Google skriver selv, at der ikke er ekstra tekniske krav ud over, at siden er indekseret og kan vises med et uddrag.
Hvad med sidetitler og metabeskrivelser?
Sidetitler og metabeskrivelser bliver tit nævnt under teknisk SEO, men de hører egentlig til on-page. Sidetitlen hjælper Google med at forstå siden. Metabeskrivelsen påvirker ikke placeringen, men den kan få flere til at klikke, især hvis den har en tydelig opfordring.
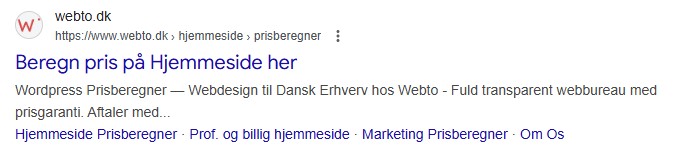
Den tekniske del er at sikre, at hver side har en unik titel og beskrivelse, og at de ikke mangler eller er dubletter. Det fanger et crawl-værktøj på få minutter.
Webtos erfaring
De tekniske fejl, der koster mest, er sjældent de avancerede. Det er et noindex-flueben, der blev glemt efter lancering, en ny hjemmeside uden redirects fra de gamle URL’er, eller en testside, der pludselig er indekseret. Derfor tjekker vi altid indeksering og redirects først, før vi bruger tid på hastighed og schema.
Tjekliste: Teknisk SEO-tjek på en time
Du kan nå det meste med gratis værktøjer: Google Search Console, PageSpeed Insights og gratisversionen af Screaming Frog, der crawler op til 500 URL’er.
- Søg på site:dittdomæne.dk i Google. Ser antallet rimeligt ud, og er der testsider eller dubletter imellem?
- Search Console, rapporten Sider: Er dine vigtigste sider indekseret? Hvad står der ved dem, der ikke er?
- Sitemap er indsendt i Search Console og indeholder kun sider med status 200.
- robots.txt blokerer ikke vigtige sider, CSS, JavaScript eller de søgecrawlere, du vil vises hos.
- Crawl sitet med Screaming Frog: ingen interne links til 404, ingen redirect-kæder, ingen manglende eller dublerede titler.
- Vigtige sider har selv-refererende canonical, og ingen vigtige sider har noindex.
- LCP, INP og CLS er grønne i PageSpeed Insights, også på mobil.
- URL-inspektion af en vigtig side viser hele indholdet i den renderede HTML.
- http, www og uden www sender alle videre til én https-adresse med én 301.
- Strukturerede data giver ingen fejl i Googles Rich Results-test.
Vil du gå et spadestik dybere, kan du følge vores guide til en grundig teknisk SEO-analyse. Vil du hellere have, at vi går det hele igennem, kan du se vores teknisk SEO-pakke.
Er det teknikken, der holder dig tilbage?
Vi finder de tekniske fejl, der koster dig synlighed, og retter dem i den rækkefølge, der giver mest effekt.
Ofte stillede spørgsmål
Kilder: Google: AI features and your website · Google: Common crawlers · web.dev: Core Web Vitals · OpenAI: Crawlers · Anthropic: Crawlers · Screaming Frog SEO Spider
“Google kan ikke rangere det, den ikke kan finde. Teknisk SEO sørger for, at den finder det hele.”
Du er velkommen til at læse mere i nogle af vores andre blogindlæg
Fik du læst disse?
-
AI-forordningen for små og mellemstore virksomheder: Det skal I vide
Af: Jannick Jensen • 29/10/2026EU’s AI-forordning bliver ofte omtalt, som om den kun handler om tech-giganter. Men den gælder også for den lille virksomhed, der bruger ChatGPT til marketing… -
AI-billeder og -video i markedsføring: Mærkning, ophavsret og rigtige personer
Af: Jannick Jensen • 28/10/2026AI kan lave produktbilleder, kampagnevisuals og videoer på få minutter. Det sparer tid og penge, men det rejser også nye spørgsmål: Skal billederne mærkes? Hvem… -
AI-politik for marketingteamet: Sådan laver I regler for AI (med skabelon)
Af: Jannick Jensen • 27/10/2026De fleste marketingfolk bruger allerede ChatGPT, Claude eller Copilot hver dag. Spørgsmålet er, om de gør det på en måde, virksomheden kan stå inde for….


